Bienvenue à la vingt septième infolettre !
Bienvenue à cette infolettre de rentrée, avec beaucoup d’annonces et d’actualités.
L’infographie
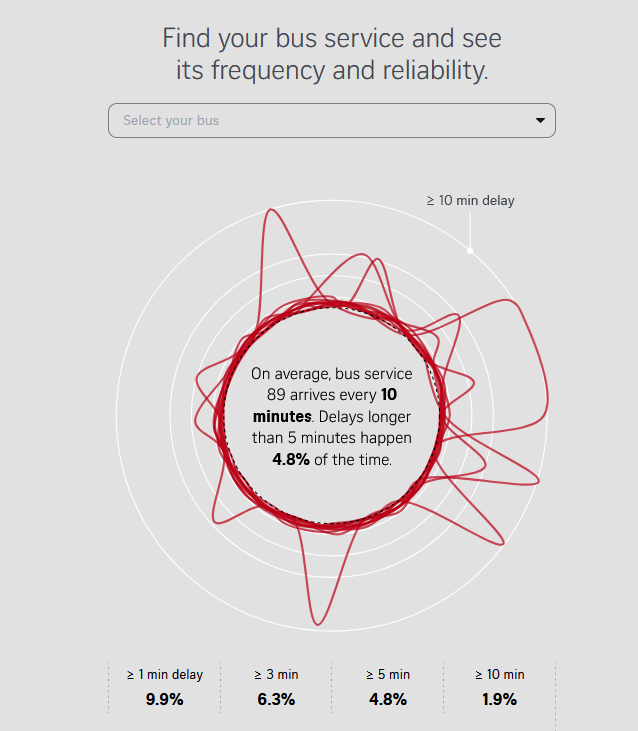
The Straits Times, journal quotidien de Singapour, publie une belle infographie sur les retards de bus à Singapour avec un style ressemblant à l’écriture extra-terrestre dans le film Premier Contact.

Dans leur article Why your wait for a bus in Singapore feels so long, ils analysent la perception des temps d’attente des bus via l’étude des temps d’arrivée réels des bus. Au-delà de l’aspect quantitatif très bien rendu, les auteurs mentionnent les impacts de la fréquence et de l’imprévisibilité de l’arrivée des bus sur l’anxiété des usagers et leur qualité de vie.
Les actualités du réseau
La quatrième journée du réseau arrive 📅 7 décembre - La Tréso (Malakoff)
Réservez votre 7 décembre ! Pour la quatrième année consécutive, le SSPLab organise la journée du réseau pour rassembler les data-scientists de la statistique publique. Au menu : présentation de projets innovants, retour d’expérience et moments d’échanges informels (autrement appelés “pots” 🎉).
Comme les années précédentes, l’événement sera en présentiel et à distance pour permettre à tous de participer. Les détails seront publiés sur la page de l’événement. Si jamais vous voulez déjà vous inscrire alors que l’agenda n’est pas finalisé, c’est possible ici.
Si vous souhaitez présenter un projet sur lequel vous travaillez, l’agenda est encore ouvert. N’hésitez pas à l’indiquer lors de l’inscription, par Tchap ou par mail.
Le site a fait peau neuve et migre vers ssphub.fr
Au cours de l’été, le site du réseau a fait une petite mue pour mieux faire connaître les projets innovants et rassembler des contenus jusqu’ici dispersés.
Le site présente maintenant des projets innovants en français et en anglais, libre à vous d’ajouter vos projets. Cela doit permettre de faciliter l’accès aux travaux du réseau et leur circulation : à l’Insee, avec les services statistiques ministériels mais aussi à l’international.
👉️ Un article de blog revient plus en détail sur ce travail.
Par exemple, sept projets de codification automatique utilisant le machine learning ou l’IA portés par l’Insee ou la Dares sont présentés. Cela couvre des projets comme la codification automatique de l’activité principale des entreprises ou celle des professions dans la PCS. Les méthodes de machine learning ont aussi été utilisées pour le changement de nomenclature de la NACE et enfin, last but not least pour constituer la base Jocas de la Dares, issue du webscraping des offres d’emploi en ligne.
Une liste de formation en data science sur le site
Une liste de formations d’intérêt pour la data science, toutes ouvertes et en ligne, est aussi disponible sur le site. Basée en partie sur le catalogue des formations du SSPCloud, cela permet d’aider à monter en compétence sur les différents sujets.
Les formations et ressources proposées couvrent Git, Quarto, Python, R, S3 et les technologies du SSPCloud. Les liens vers les différents funathons, formations à Python, au MLOps et les documents de travail sont aussi rappelés.

N’hésitez pas à proposer de créer de nouvelles formations ou à nous suggérer la mention d’autres formations existantes !
Actualités du SSP Cloud
Le service d’accès aux grands modèles de langage (LLM) llm.lab, modèles auto-hébergés sur le SSP Cloud, devient de plus en plus connu et sollicité par les utilisateurs de la célèbre plateforme open-source de data science. Depuis peu, un nouvel outil est disponible pour les utilisateurs les plus aguerris, avides de tester toujours plus de nouveaux LLM : le déploiement de LLM à la demande.
Le concept : à partir d’un fichier YAML comprenant la configuration du LLM (contrat de déploiement), le modèle peut être déployé sur la plateforme, sous réserve de disponibilité de GPU (un modèle = un GPU).
Comment ça marche ? Une fois le contrat de déploiement ajouté dans le projet GitHub sspcloud-llm et les poids du modèle à déployer ajoutés dans le S3 du SSP Cloud, le modèle est déployé automatiquement sur la plateforme via ArgoCD. La disponibilité du nouveau modèle est aussi observable sur status.lab.sspcloud.fr.
Les limites : en plus de la disponibilité des GPU, une deuxième limite est la capacité maximale en VRAM des GPU (mémoire vive associée à la carte graphique). Les GPU avec le plus de VRAM disponible sur la plateforme du SSP Cloud disposent d’environ 90 Go ; ils ne peuvent pas héberger les plus gros modèles disponibles en open-weight (c’est-à-dire des LLM avec des poids qui sont téléchargeables). Des modèles comme
Kimi K3ouDeepSeek V4.1-Flashont un nombre de paramètres totaux (resp. 2 800 et 552 milliards) bien trop élevé pour la capacité d’un GPU du SSP Cloud.
Actualités en data science
Avec la pause estivale, de nombreuses actualités en data science et ressources sont sorties. Voici un panorama synthétique des innovations relevées.
IA
Efficacité de l’IA
L’étude Do Data Agents Need Semantic Metadata? A Comparative Study in Agentic Data Retrieval de Google montre l’importance d’avoir des données structurées pour augmenter l’efficacité des agents autonomes. En effet, les agents utilisant des métadonnées structurées surpassent nettement ceux naviguant sur le web non structuré en termes de précision (45% de réussite contre 20% pour les agents sans accès à des métadonnées) et de conformité aux principes FAIR (l’agent de base réussit environ 40% des questions contre 66% pour les agents avec accès aux métadonnées structurées).
Un article publié dans le NBER, AI Agents and Prompt Engineering in Econometric Coding, analyse l’efficacité des LLM pour la rédaction de code économétrique entre chatbots et agents autonomes, c’est à dire pouvant tester le code qu’ils proposent et le corriger, sur Stata, R et Python. L’étude a utilisé les modèles Sonnet 4.6 de Claude, GPT 5.4 et DeepSeek V4 Flash. Résultat, sur 21 tâches dédiées, les agents autonomes sont bien plus efficaces que des chatbots et réussissent dans 96% des cas lorsqu’il interagit avec l’humain (95% sans interaction). Les LLM codent par ailleurs le mieux en Python et en R, et notamment avec un écart de taux de succès non significatif entre les deux langages. Ils codent par contre largement moins bien en Stata (33% de réussite sur les tâches demandées).
Le site FrontierHarness Eval évalue 12 environnements pour agents IA sur des tâches de génie logiciel par taux de réussite, vitesse et coût par tâche. Codex est celui qui réussit le mieux (67% des tâches) à un coût pourtant six fois moindre que Claude Code.
Adaptation à l’usage de l’IA
Un certain nombre d’outils et de site ont annoncé le déploiement d’outils ou de techniques pour protéger leur contenu de l’IA.
Codeberg, une forge git allemande libre, annonce des mesures pour protéger l’écosystème libre des LLM dans un blog Protecting our FLOSS commons from LLMs : l’association s’engage ainsi à ne pas utiliser les données des utilisateurs pour l’entraînement de LLMs et modifie ses conditions d’utilisation pour proscrire les projets vibe-codés. Par ailleurs, les membres de l’association ont adopté une motion estimant que les LLM mettent en danger l’écosystème des logiciels libres.
Un développeur néerlandais, Isaque Seneda, a développé ShieldFont, une police open-source qui empoisonne les jeux de données d’entraînement de LLM par substitution de texte tout en permettant une lecture humaine normale.
Alors que les contenus générés par IA sont de plus en plus nombreux, savoir les détecter est devenu d’autant plus important. Anthropic a ainsi présenté dans ce post de blog How Claude marks AI-generated content ses deux méthodes maison pour marquer les textes ou fichiers générés par ses modèles. Anthropic a aussi mis en place un site pour vérifier si un fichier a été généré par Claude. Pour savoir comment cela fonctionne, des universitaires, issus en grande partie d’universités chinoises, ont fait un tour des différentes techniques de marquage de textes produits par les LLMs dans leur article A Survey of Text Watermarking in the Era of Large Language Models.
Ressources
Python
- mcpgen : Transformez n’importe quelle API en serveur MCP Python : Outil de génération automatique de serveurs MCP à partir de spécifications OpenAPI ou de collections Postman.
R
rv : Gestionnaire de packages R reproductible et déclaratif : Outil permettant de gérer et d’installer des packages R de manière rapide, déclarative et reproductible à la
uvmais pour R.ggplot2qgis : Export de cartes ggplot2 et tmap vers QGIS : Package R permettant d’exporter des graphiques spatiaux vers des fichiers de projet QGIS en préservant les échelles de couleurs, les styles de couches et en gérant les données vectorielles.
ir 0.1.0 : self-describing R scripts and Quarto documents : Lancement de
ir, un outil en ligne de commande pour exécuter des scripts R et documents Quarto. Il permet de gérer automatiquement les dépendances et les versions de R directement depuis le fichier, comme avecuv.Introducing lorax : Speaking for the Tree-Based Models : Présentation de
lorax, un nouveau package R conçu pour caractériser et visualiser les modèles basés sur des arbres. Il permet d’extraire les règles de décision, d’identifier les prédicteurs utilisés et d’uniformiser l’accès aux caractéristiques de divers modèles.mcptools 1.0.0 : le premier SDK R pour le Model Context Protocol : Lancement de la version 1.0.0 de mcptools sur CRAN. Ce SDK permet de déployer et de récupérer des outils MCP en R, avec support des images et des serveurs authentifiés.
Typst
Mosaic : Beautiful slides for Typst : Outil permettant de créer des présentations de type slides directement avec Typst.
Build LinkedIn Carousels with Typst : the slide Layout : Tutoriel pour créer des carrousels LinkedIn avec Typst.
OCR : Un doctorant de Harvard présente socOCRbench, un nouveau benchmark d’OCR conçu pour les sciences sociales. Il évalue la reconnaissance de manuscrits, l’extraction de tableaux et de textes imprimés sur des documents complexes.
Guide to data tools landscape for developers : Guide d’introduction au paysage des outils de données pour les développeurs qui présente les différents métiers de la donnée et les étapes du cycle de vie de la donnée (ETL). Le guide est pensé à destination de développeurs arrivant dans un environnement data et nouveaux dans la matière.
Fun/formation
Vous cherchez un chiffre similaire à un autre et montrer par exemple à vos élèves l’importance des métadonnées ? Spurious Comparisons permet de rechercher des statistiques par valeur absolue. Cela permet par exemple de voir que 666 c’est le nombre de vue pour la page Wikipedia de Narendra Modi le 15 septembre 2025 mais aussi la quantité de sulfates et autres produits chimiques exportés en 2021 par l’Equateur. Coïncidence ?
Un package R dédié cpge permet d’aider les étudiants en CPGE à choisir leur orientation et de voir les concours et secteurs d’activité des grandes écoles françaises.
Une étonnante étude qui montre que l’humain est assez fort pour optimiser seul des problèmes complexes. Why some people mow a lawn better than others permet d’analyser 132 003 tentatives de tonte de pelouse virtuelle pour étudier l’efficacité humaine et les compare aux algorithmes de planification de trajectoire.
Une plongée dans des articles plus exhaustifs
Self-hosting DuckDB : the road to production : Guide pratique sur l’auto-hébergement de DuckDB selon différents niveaux de maturité. Analyse des compromis entre construction maison et services managés en passant du laptop au cloud.
How an AI agent signed itself up to MotherDuck and built a pipeline : Un agent IA provisionne de manière autonome un entrepôt de données cloud sans inscription humaine. L’article explore les nouveaux flux de travail où les agents gèrent l’infrastructure, l’ingestion de données et la visualisation.
Grokking Apache Iceberg : Exploration approfondie du fonctionnement technique d’Apache Iceberg : comparaison avec l’ancien modèle Hive et démonstration des avantages du format de table pour la gestion des métadonnées.